

写在前面
最近集中折腾了一段时间插件开发,过程中陆续试用了国内几家大模型 API。踩了些坑,也有了一些真实数据。这篇文章不吹不黑,纯粹从一个开发者的实际体验出发,记录一些关于 API 选型的观察,供有类似场景的朋友参考。
一个被低估的指标:缓存命中率
在讨论具体平台之前,有必要先聊一个很多人选型时会忽略的维度——上下文缓存命中率。
写代码这件事有个特点:迭代过程中,上下文重复率天然很高。系统提示词、之前的对话历史、历史版本的代码、之前报的错,这些东西会随着轮次不断累积,每一次新的修改请求里,绝大部分 token 其实是重复的。
如果能命中缓存,这部分重复 token 的计费价格通常只有标准输入价的零头。以 DeepSeek 官方定价为例,V4-Pro 的缓存命中输入在高峰时段是 $0.044/百万 Token,而未命中的输入是 $1.32/百万 Token,差了 30 倍。V4.1 Flash 的缓存命中更是低至 $0.006/百万 Token(高峰)。
我最近一次任务的数据是:单次消耗 41,460,050 token,缓存命中率 98%。未缓存输入只有 64 万 token,其余 4074 万全部走了缓存读取。这意味着真正按原价买单的部分,不到总量的 2%。
这个数据让我意识到,对于”长上下文 + 反复迭代”这类高重复度的编码场景,缓存机制才是决定实际成本的第一变量,而非标价本身。
四家平台的简单对比
以下价格数据来自各平台官方文档(截至 2026 年 10 月),我不做”谁好谁坏”的结论,只陈列事实。

DeepSeek
DeepSeek 目前主推 V4.1 Flash(API ID: deepseek-flash),V4-Pro 的请求已被路由至 Flash,两者 API 层面合并。
V4.1 Flash 高峰时段:缓存未命中输入 $0.30/百万 Token,缓存命中输入 $0.006/百万 Token,输出 $1.20/百万 Token。
V4.1 Flash 低谷时段:缓存未命中输入 $0.15/百万 Token,缓存命中输入 $0.003/百万 Token,输出 $0.60/百万 Token。
高峰时段为北京时间周一至周五 09:00–12:00 及 14:00–18:00,其余时段(含周末和法定节假日)全部按低谷价计费。
从实际使用来看,在高重复度的编码场景中,DeepSeek 的缓存机制表现相当稳定,综合成本可以压到比较低的水平。
阿里千问
千问 Max 系列定位旗舰,价格也相应更高。qwen3.8-max 当前定价为输入 $2/百万 Token、输出 $6/百万 Token(国际区域)。qwen3.7-max 为 $2.5/$7.5。
千问的缓存机制支持显式缓存和隐式缓存,缓存命中输入价格约为标准价的 10%。不过从实际体验来看,千问在编码场景中的缓存命中率可能不如专注长上下文优化的平台稳定,这或许与缓存策略的实现方式有关。
智谱 GLM
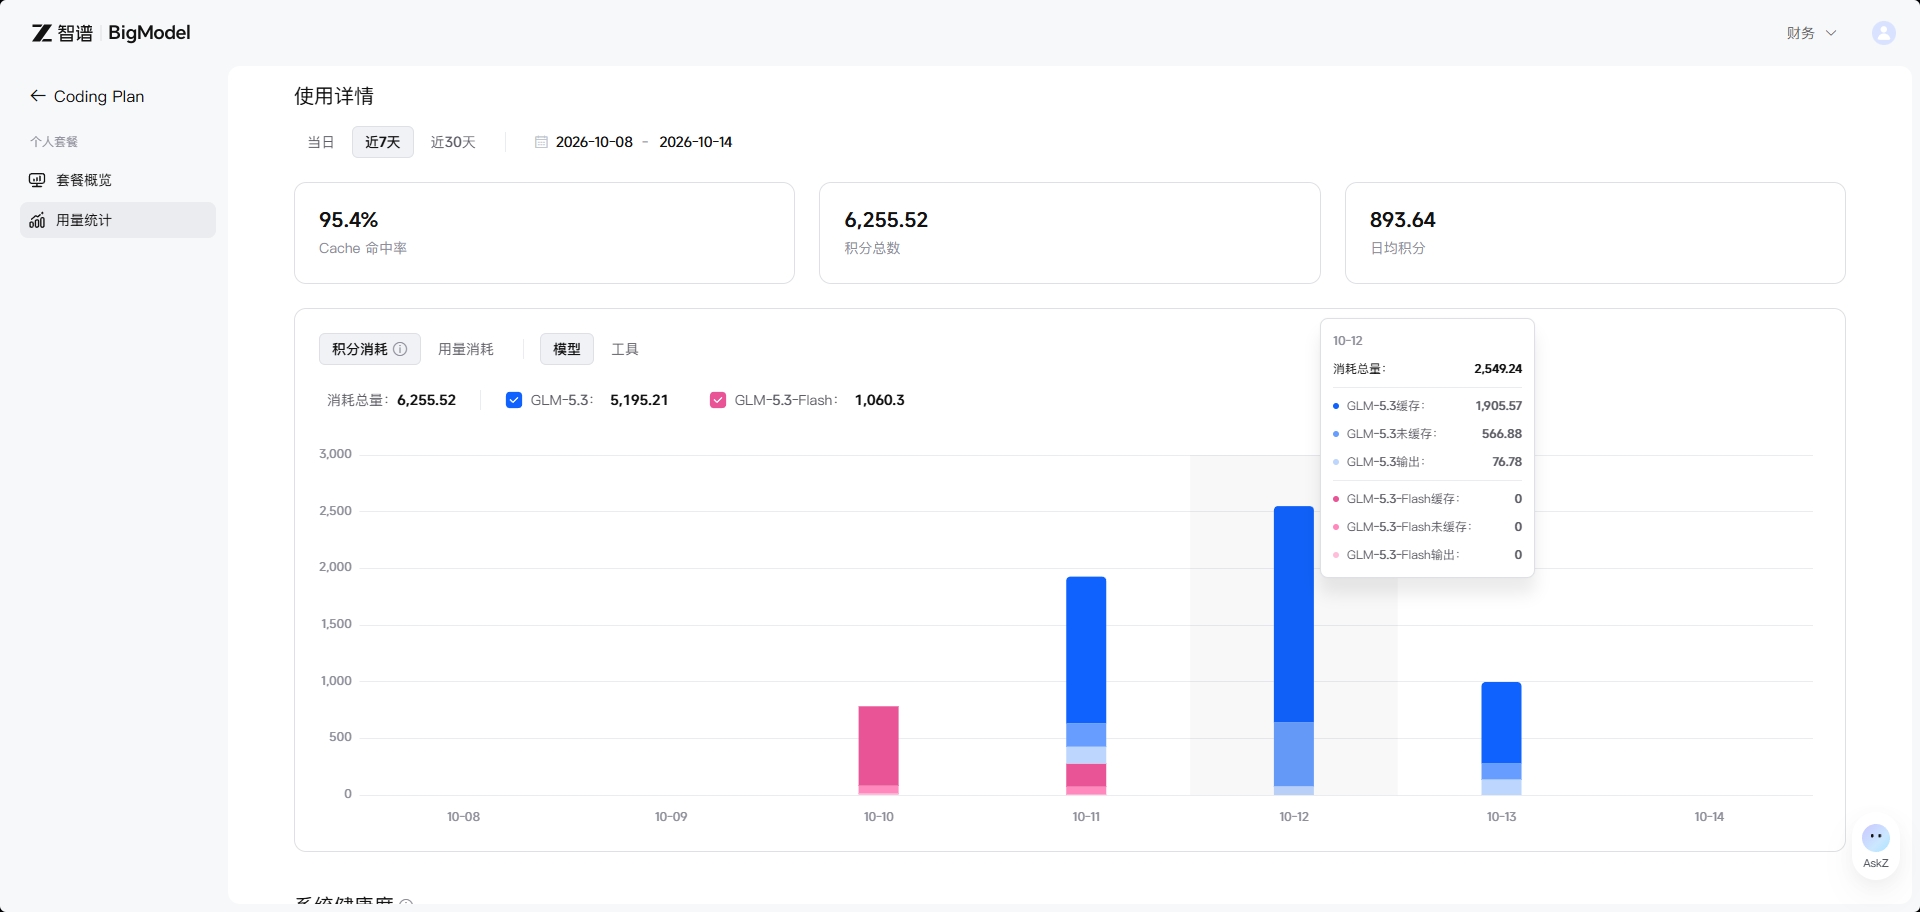
智谱 GLM-5.3 定价为输入 8 元/百万 Token、输出 28 元/百万 Token,缓存命中 2 元/百万 Token。GLM-5.3-Flash 则便宜很多,输入 0.8 元、输出 2.8 元、缓存命中 0.23 元。
智谱的 Coding Plan 套餐在开发者中讨论度较高,但其 5 小时限流机制对连续编码场景不太友好。如果你习惯一口气改很多轮代码,中途被限制的感觉会比较打断节奏。
小米 MiMo
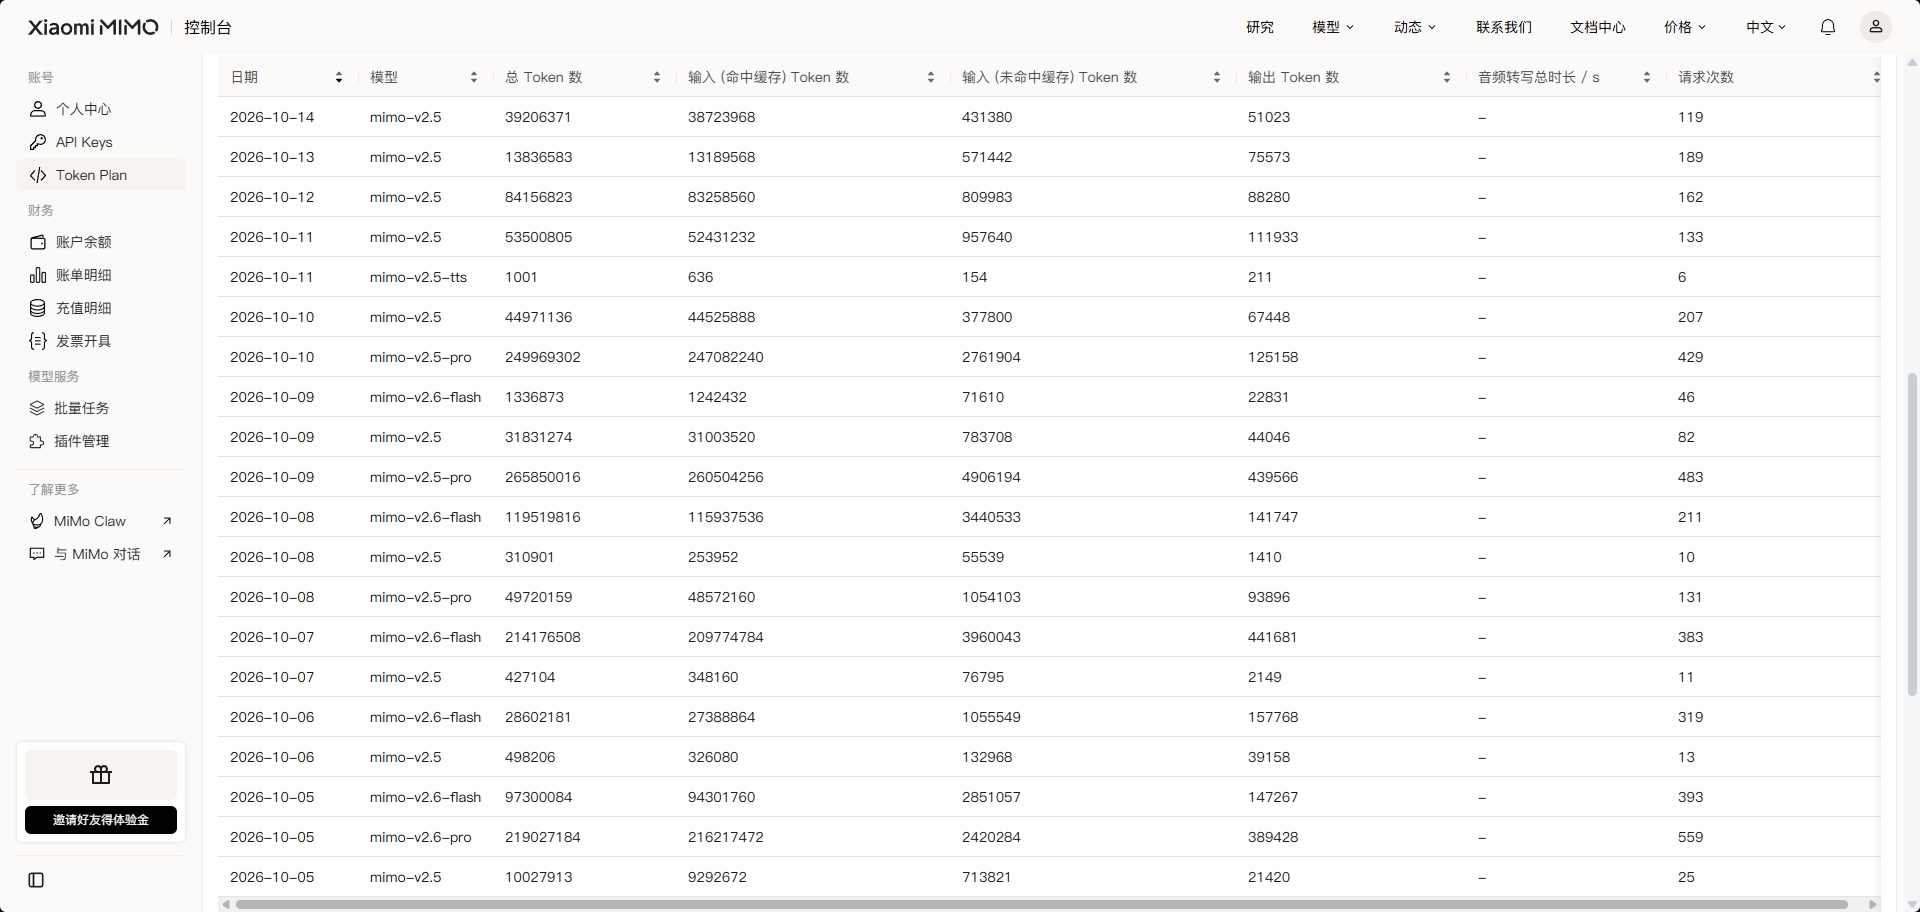
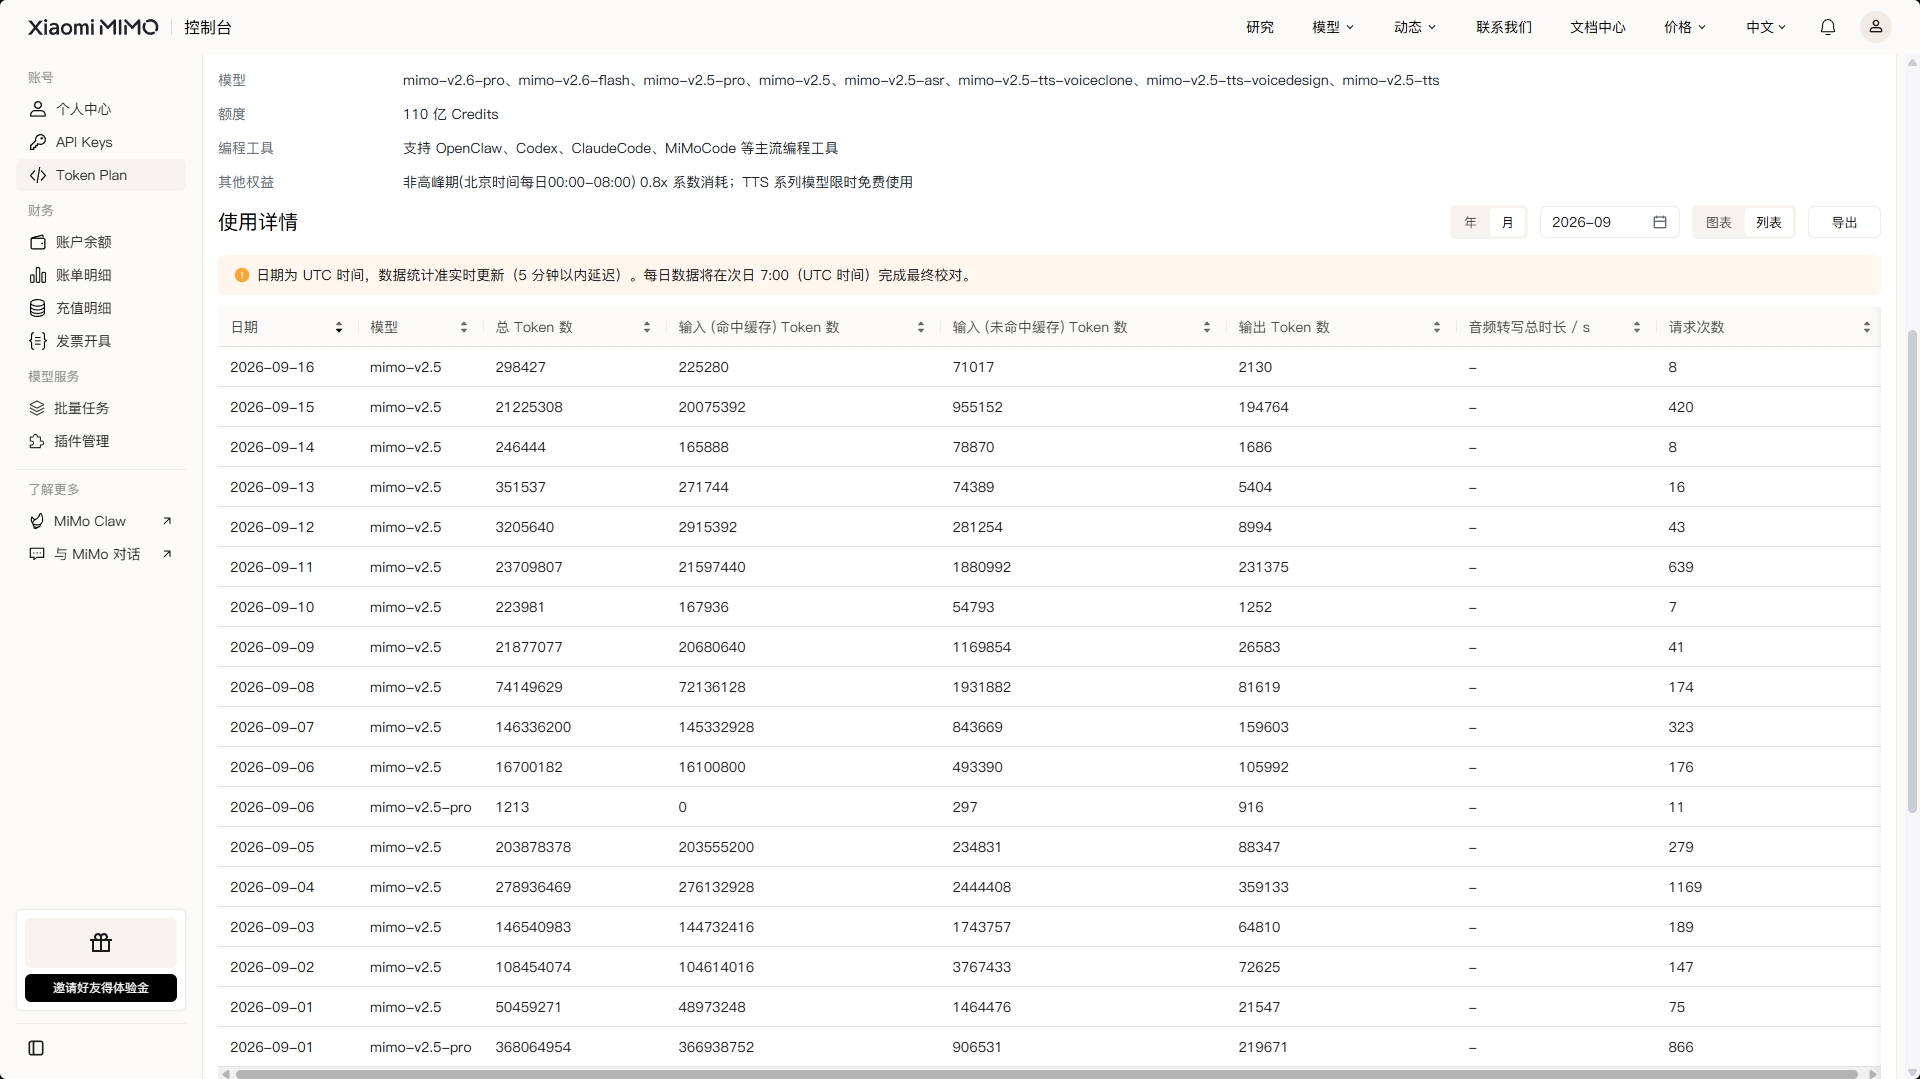
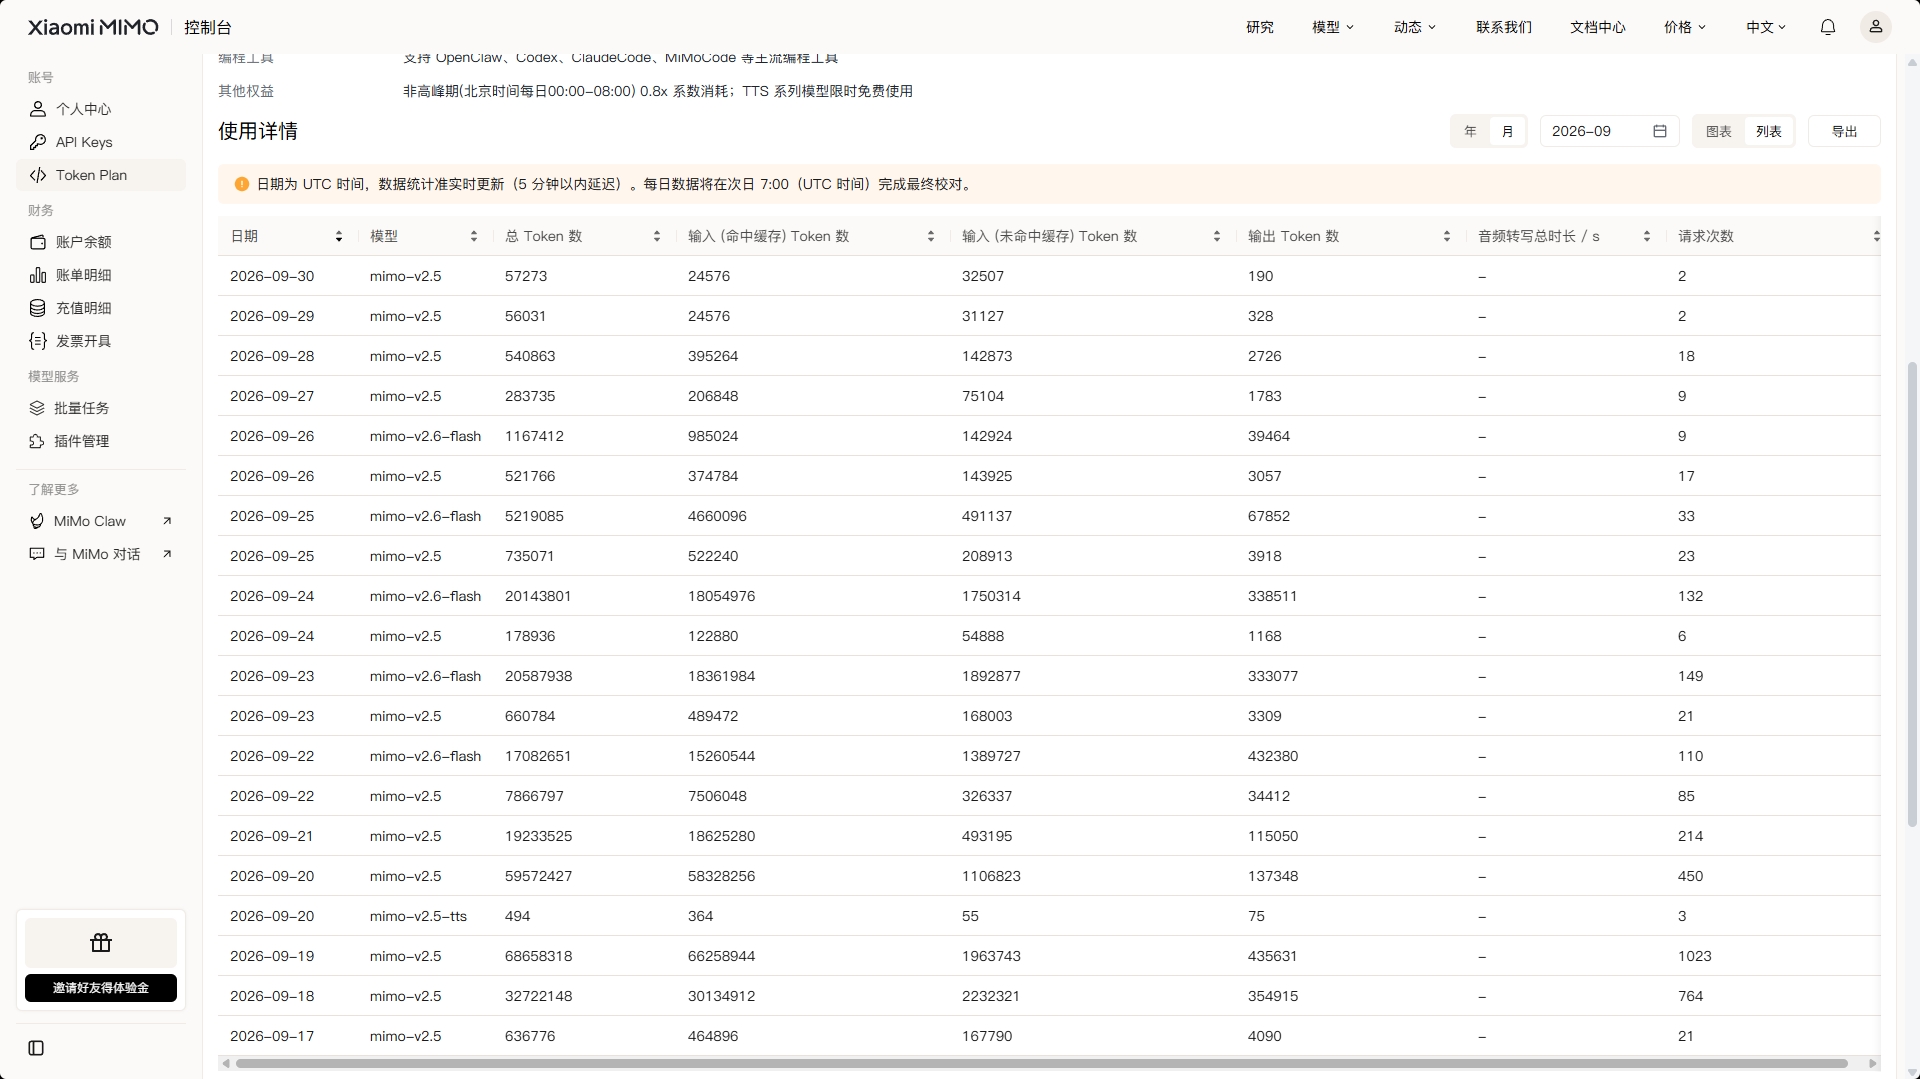
小米 MiMo V2.6 Pro 定价为输入 $0.435/百万 Token、输出 $0.87/百万 Token,缓存命中仅 $0.0036/百万 Token。Flash 版定价为输入 1 元/百万 Token、输出 2 元/百万 Token,据称提供 99% 缓存折扣。
小米提供 Token Plan 月度套餐,优势是没有 5 小时窗口限制,可以集中消耗。但如果消耗量很大,Standard 档位的额度可能会偏紧。
一个开发者的真实账本
说了这么多,最有说服力的还是实际账单。
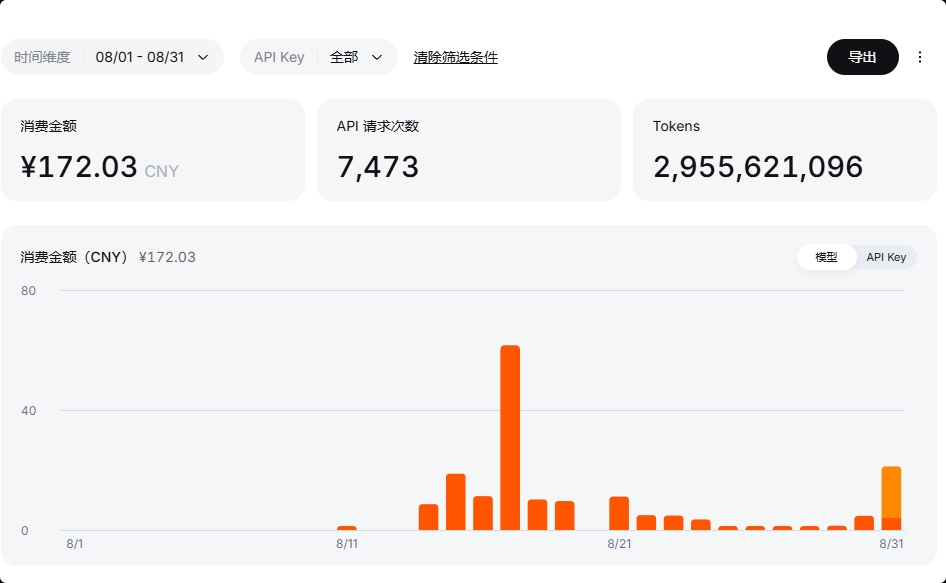
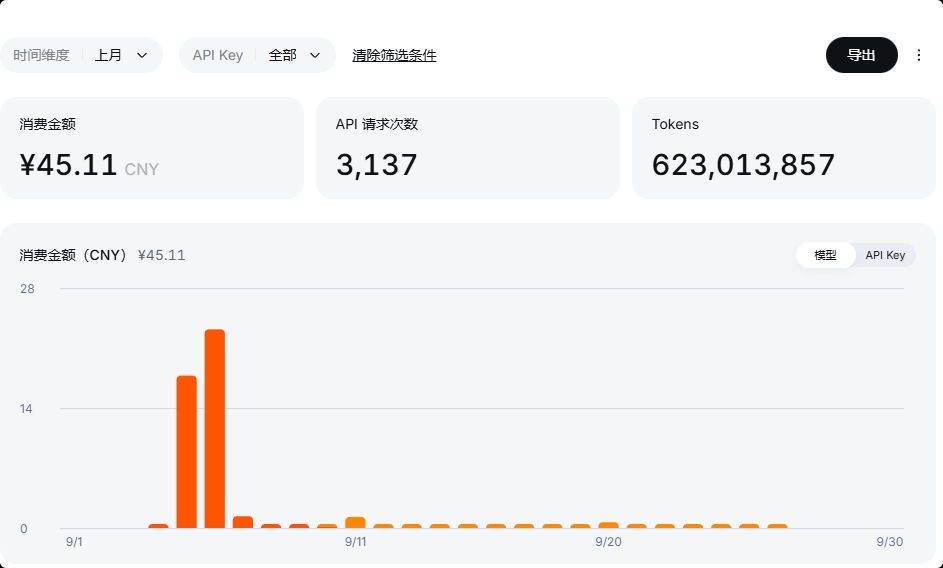
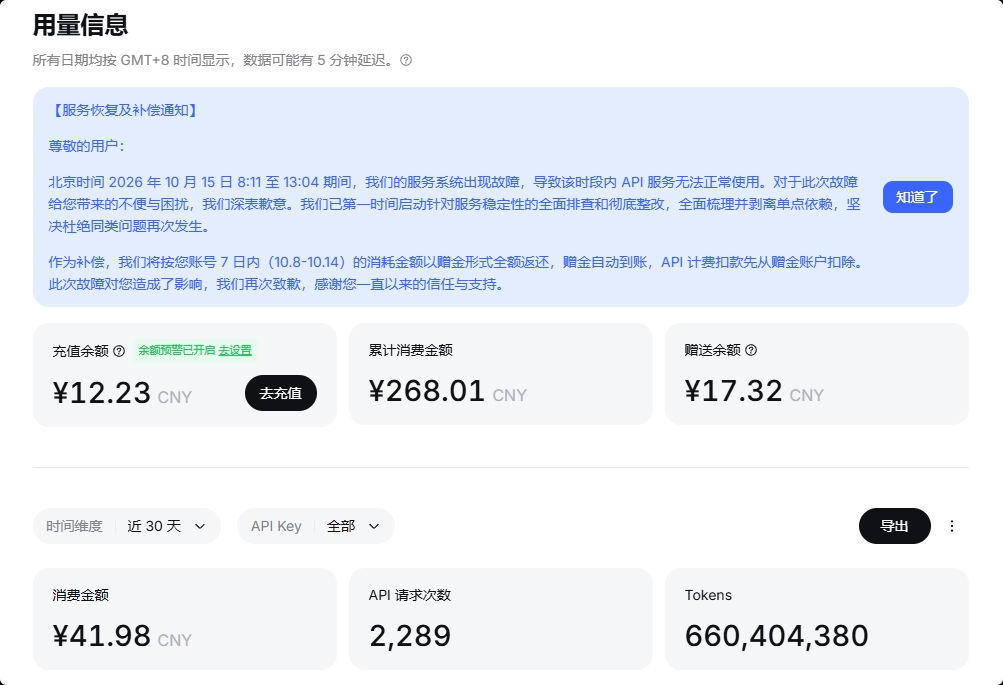
我 8 月在 DeepSeek 的消耗数据是:29.55 亿 Token,实付 172.03 元。9 月 6.23 亿 Token,实付 45.11 元。
这个成本水平,结合上面展示的 98% 缓存命中率数据,说明了一件事:在高度重复的编码迭代场景下,缓存机制的实际影响远超标价差异。
当然,这不意味着其他平台”贵”。千问 Max 的定位是综合能力旗舰,定价反映的是不同目标场景;智谱 Flash 的 0.8 元/百万 Token 输入价格对轻量任务很有吸引力;小米的缓存折扣力度同样很大。差别在于你的使用模式是否匹配该平台的计费优势。
选型思路小结
基于这几周的体验,我个人的结论是:
如果你的工作流是”长上下文 + 反复迭代 + 高度重复前缀”,那么优先关注缓存命中价格和缓存命中率,比关注标准输入标价更有意义。
如果你的场景是”短请求、低频、单次任务”,标准输入价格才是主要成本。
如果对”限流窗口”敏感(比如习惯连续多轮修改),选择没有 5 小时限制的计费模式会更顺畅。
没有 universally 最好的平台,只有和你使用模式最匹配的选择。
以上价格数据均来自各平台官方文档,可能随平台政策调整而变化,具体以官方实时定价页为准。本文仅为个人使用记录,不构成任何采购建议。




暂无评论内容